


KI im regulierten Umfeld validieren: Validierung beginnt vor der Modellauswahl
Künstliche Intelligenz ist in der Life-Sciences-Branche angekommen. Unternehmen prüfen Anwendungen für Qualitätsmanagement, Produktion, visuelle Inspektion, Dokumentation, Stammdaten und viele weitere Prozesse.
Mit der technischen Möglichkeit entsteht jedoch eine zentrale Frage:
„Wie lässt sich ein KI-gestütztes System in einem regulierten Umfeld validieren?“

Die Antwort lautet nicht: mit einer vollständig neuen Validierungsmethode. Die etablierten Grundprinzipien bleiben relevant. Allerdings müssen sie um KI-spezifische Aspekte ergänzt werden – insbesondere um den Modell- und Daten-Lifecycle, Daten-Governance, Kontrollen (z.B. Guardrails, Human-in-the-loop) und Leistungsanforderungen für kontinuierliches Monitoring.
Was bei KI-gestützten Systemen anders ist
Bei einem klassischen Computersystem wird die Funktion im Wesentlichen durch Softwarelogik, Konfiguration und festgelegte Regeln bestimmt. Das Verhalten ist vorhersehbar, reproduzierbar und testbar. Bei einem KI-(gestützten) System prägen die Daten das System. KI-(gestützte) Systeme lernen ihr Verhalten aus Beispieldaten. Ergebnisse können sich durch neuartige Eingaben verändern, nicht vollständig im Voraus geprüft und nicht immer nachvollziehbar begründet werden.
Die Daten sind nicht nur technischer Input/Output. Sie prägen die Leistungsfähigkeit und das Verhalten des Modells. Deshalb benötigen KI-Anwendungen eine belastbare Daten-Governance und eine nachvollziehbare Kontrolle über den Daten-Lifecycle.
Damit erweitert sich bei KI-(gestützten) Systemen die Validierung um die Prüfung von Daten, Modell und Leistung. Neben den klassischen Anforderungen an Funktionen und Prozesse müssen unter anderem folgende Fragen beantwortet werden:
- Welche Anforderungen in Bezug auf Daten gelten für das Modell?
- Sind die verwendeten Daten für den Zweck geeignet und repräsentativ?
- Wie werden Trainings-, Evaluierungs- und Testdaten voneinander getrennt?
- Welche Leistungskriterien gelten für das Modell?
- Wie wird der Release-Kandidat des Modells ausgewählt?
- Wie werden Modellleistung und Veränderungen im Betrieb überwacht?
- Wie wird eine Modelländerung bewertet?
Das heißt: Um eine KI-Anwendung reproduzierbar, nachvollziehbar und testbar zu machen, braucht man gezielte Kontrollmaßnahmen, die bei klassischen Anwendungen in der Form nicht notwendig sind.
Validierungsaufwand abschätzen: Wegweisende Aktivitäten in der Konzeptphase
Ausgangspunkt für die Einschätzung des Validierungsaufwands bleiben der Intended Use (definierter Verwendungszweck), das damit verbundene Risiko und die Systemkomplexität.
Bei KI-(gestützten) Systemen im regulierten Umfeld kommt neben den GxP-Risiken (Patientensicherheit, Produktqualität und Datenintegrität) eine weitere Risikoperspektive hinzu. Die EU-KI-Verordnung ordnet KI-Systeme branchenübergreifend risikobasiert ein. Beide Betrachtungen müssen zusammengeführt und beurteilt werden – sie ersetzen einander nicht. [1]
Ein Beispiel ist eine KI-basierte visuelle Inspektion von Arzneimittelverpackungen. Die Anwendung kann aus einer allgemeinen KI-Risikoperspektive anders einzuordnen sein als aus GxP-Sicht. Für die Validierung ist deshalb der konkrete Prozesszusammenhang entscheidend.
Bei der Beschreibung des Intended Use sind insbesondere die Interaktion zwischen Mensch und System, die Aufgabenverteilung sowie die Verantwortlichkeiten bei Entscheidungen zu berücksichtigen.
Für die Einschätzung der Komplexität KI-gestützter Systeme sind nicht nur der vorgesehene Modelltyp und der Grad der Autonomie relevant. Ebenso zu betrachten sind der Nutzungskontext – insbesondere Art, Herkunft und Qualität der verwendeten Daten – sowie die Betriebsbedingungen im laufenden Betrieb.
Das Zusammenspiel dieser Elemente macht KI-gestützte Anwendungen zu komplexen Systemen. Daher sollte die Konzeptphase erweitert werden, um das Gesamtgefüge systematisch zu analysieren. Das schafft die Grundlage für ein belastbares Systemverständnis und einen präzise definierten Intended Use. Beides ist Voraussetzung für eine geeignete und sichere Modellauswahl. Die Ergebnisse der Konzeptphase fließen in die Risikobewertung, die Anforderungen an Modell und Daten sowie in die Leistungsmetriken und Akzeptanzkriterien ein.
Der Proof of Concept ist Teil der Risikobetrachtung
- Welches Problem soll die Anwendung lösen?
- Welche Modelle kommen grundsätzlich infrage?
- Welche Daten stehen zur Verfügung?
- Welche Leistungsmerkmale und Grenzen sind zu erwarten?
- Welche Risiken entstehen durch Fehlklassifikationen, nicht repräsentative Daten oder Modelländerungen?
Erweiterte CSV im Betrieb: Drift erkennen, Eignung sichern
Ein einmalig erfolgreich getestetes Modell bleibt nicht automatisch dauerhaft unverändert oder gleich leistungsfähig. Im Betrieb können sich Daten, Prozesse, Nutzerverhalten oder Umgebungsbedingungen verändern. Dadurch können unter anderem Data Drift oder Model Drift entstehen.
Die Validierungsstrategie muss deshalb durch erweiterte KI-spezifische Aktivitäten im laufenden Betrieb die Eignung sichern. Ergänzend zu bestehenden Prozessen wie Change Management und Periodic Review braucht es je nach Anwendung:
- definierte Monitoring-KPIs,
- technische Kontrollen (Guardrails)
- Schwellenwerte und Eskalationswege,
- Regeln für Modelländerungen und Re-Assessment,
- Vorgaben für den Umgang mit auffälligen Ergebnissen,
- klare Verantwortlichkeiten zwischen Fachbereich, IT, QA, CSV und gegebenenfalls Data Science.
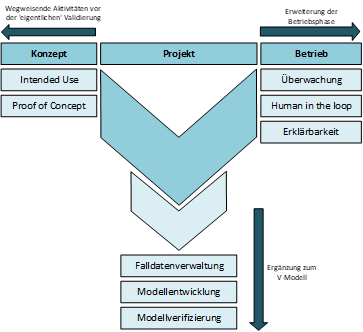
Das klassische V-Modell wird ergänzt – nicht ersetzt
Ein risikobasierter Ansatz für KI-gestützte Systeme baut auf bekannten CSV-/CSA-Prinzipien auf. Ergänzt werden insbesondere:
- Definition des Intended Use und der Integration in den Geschäftsprozess,
- Anforderungen an Modell, Datenqualität und Daten-Governance, und Überprüfung im Proof of Concept,
- iterative Modellentwicklung und Auswahl eines Release-Kandidaten,
- modellbezogene Verifikation,
- Integration in die End-to-End-Tests des Gesamtsystems,
- fortlaufende Überwachung im Betrieb.
Damit entsteht keine pauschale Standardmethode für jede KI-Anwendung bzw. jedes KI-gestützte System. Der konkrete Ansatz muss weiterhin risikobasiert über den Intended Use, das Modell, die Daten, den Grad der Autonomie und die Systemkomplexität definiert werden.
Was Unternehmen jetzt tun sollten
Unternehmen, die KI in einem regulierten Prozess einsetzen möchten, sollten mit fünf Schritten beginnen:
- Intended Use eindeutig beschreiben
Was soll das System leisten und in welchem Prozess wird es eingesetzt? - Risiko aus mehreren Perspektiven bewerten
GxP-Kritikalität, die Perspektive der EU KI-Verordnung, Systemkomplexität und Datenrisiken gehören zusammen betrachtet. - Modell- und Datenanforderungen definieren
Anforderungen an Leistungsfähigkeit, Repräsentativität, Datenqualität und Nachvollziehbarkeit sollten früh feststehen. - Proof of Concept kontrolliert durchführen
Frühe Experimente sollten dokumentiert und in die spätere Entscheidungs- und Validierungslogik eingebunden werden. - Betrieb und kontinuierliche Kontrolle planen
Überwachung (Trends, Guardrails), Periodic Review, Change Management und der Umgang mit Drift müssen vor dem Go-live bedacht werden.
Fazit
KI-Validierung bedeutet nicht, bewährte CSV-/CSA-Prinzipien vollständig zu ersetzen. Es geht darum, sie für lernende, probabilistische, sich entwickelnde Systeme fit zu machen.
Der wichtigste Ausgangspunkt ist dabei nicht die Frage, ob ein System generative KI, Machine Learning oder ein anderes Modell verwendet. Entscheidend ist:
„Welche Funktion erfüllt die KI im konkreten Prozess, welches Risiko entsteht daraus und wie wird die Kontrolle über den gesamten Lebenszyklus sichergestellt?“
Im ausführlichen Praxisleitfaden zeigt DHC, wie sich Intended Use, GxP-Kritikalität, Modell- und Daten-Lifecycle sowie Monitoring in einen nachvollziehbaren Validierungsansatz integrieren lassen.
Wie validieren Sie KI-gestützte Systeme risikobasiert?
Im ausführlichen Praxisleitfaden zeigt DHC, wie sich Intended Use, GxP-Kritikalität, Modell- und Daten-Lifecycle sowie Monitoring zu einem nachvollziehbaren Validierungsansatz verbinden lassen.

Quellen und redaktioneller Hinweis
[1] Europäische Kommission: AI Act – Regulatory framework for artificial intelligence
[2] ISPE: ISPE GAMP® Guide: Artificial Intelligence
[3] Europäische Kommission: Stakeholder consultation zu EudraLex Volume 4, Kapitel 4, Annex 11 und vorgeschlagenem Annex 22
Häufige Fragen zur Validierung von KI-Systemen
Warum reicht klassische CSV-Validierung für KI-Systeme nicht aus?
Was ist der Intended Use und warum ist er bei KI so wichtig?
Welche Risikoperspektiven müssen bei KI im regulierten Umfeld betrachtet werden?
Zum einen die GxP-Risiken für Patientensicherheit, Produktqualität und Datenintegrität. Zum anderen die risikobasierte Einordnung nach der EU-KI-Verordnung. Beide Betrachtungen müssen zusammengeführt bewertet werden, denn sie ersetzen einander nicht. Eine KI-Anwendung kann aus Sicht der KI-Verordnung anders einzustufen sein als aus GxP-Sicht.
Warum ist der Proof of Concept Teil der Validierungsstrategie?
Der Proof of Concept prüft in der Konzeptphase früh, welches Problem gelöst werden soll, welche Modelle infrage kommen, welche Daten verfügbar sind und welche Leistung zu erwarten ist. Außerdem zeigt er Risiken wie Fehlklassifikationen, nicht repräsentative Daten oder Modelländerungen. Experimente sollten dokumentiert und in die spätere Entscheidungs- und Validierungslogik eingebunden werden.
Was sind Data Drift und Model Drift, und wie lassen sie sich kontrollieren?
Data Drift und Model Drift entstehen, wenn sich Daten, Prozesse, Nutzerverhalten oder Umgebungsbedingungen verändern. Dadurch kann die Eignung eines Modells im Betrieb sinken, obwohl es bei der Validierung erfolgreich war. Zur Kontrolle dienen definierte Monitoring-KPIs, technische Guardrails, Schwellenwerte mit Eskalationswegen, Regeln für Modelländerungen und Re-Assessments sowie klare Verantwortlichkeiten. Diese Maßnahmen ergänzen Change Management und Periodic Review.
Ersetzt die KI-Validierung das klassische V-Modell?
Nein. Das V-Modell wird ergänzt, nicht ersetzt. Hinzu kommen unter anderem die Definition des Intended Use, Anforderungen an Modell und Datenqualität, iterative Modellentwicklung mit Auswahl eines Release-Kandidaten, modellbezogene Verifikation, die Integration in die End-to-End-Tests sowie die fortlaufende Überwachung im Betrieb.
Mit welchen Schritten sollten Unternehmen starten?
Unternehmen sollten fünf Schritte gehen: Intended Use eindeutig beschreiben, Risiken aus mehreren Perspektiven bewerten, Modell- und Datenanforderungen früh definieren, den Proof of Concept kontrolliert durchführen und Betrieb sowie kontinuierliche Kontrolle vor dem Go-live planen.